Công nghệ
16/09/2026 10:54OpenAI lộ "góc khuất": Thuê hàng trăm nhân sự đọc hội thoại của người dùng ChatGPT

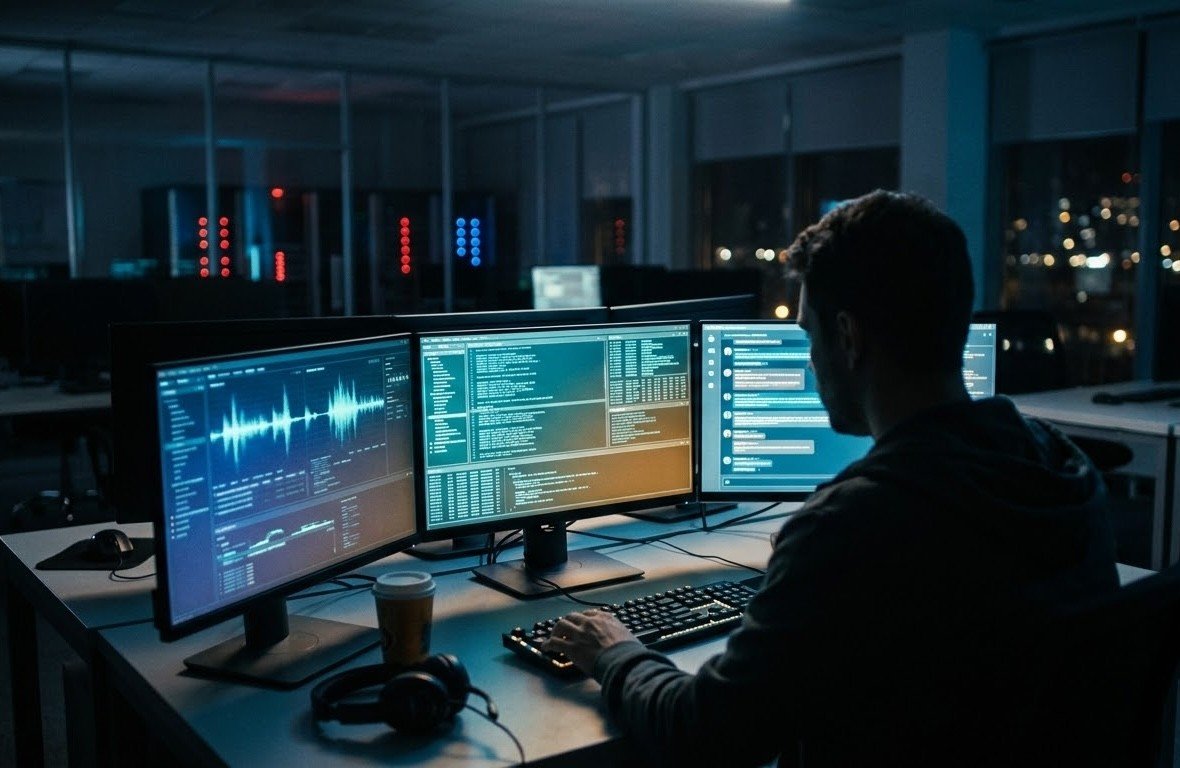
Một cuộc điều tra mới đây từ chuyên trang 404 Media đã hé lộ về chiến dịch bí mật mang tên Project Lily, nơi OpenAI chiêu mộ hàng trăm người chỉ để đọc và chấm điểm các cuộc hội thoại thực tế của người dùng ChatGPT, làm dấy lên những lo ngại sâu sắc về vấn đề bảo mật thông tin cá nhân.
Dự án Project Lily và nỗ lực "gọt giũa" hành vi của trí tuệ nhân tạo
Theo phát hiện của 404 Media, OpenAI đang vận hành dự án kiểm duyệt nội bộ Project Lily với mục tiêu chính là nâng cao chất lượng phản hồi từ mô hình. Để phục vụ chiến dịch này, công ty sẵn sàng chi trả mức thù lao hơn 50 USD mỗi giờ cho các nhân viên đánh giá. Nhiệm vụ thường nhật của lực lượng này là đọc trực tiếp các đoạn hội thoại thực tế giữa người dùng với ChatGPT để tiến hành cho điểm mức độ hoàn thiện của câu trả lời.
Hệ thống tiêu chí đánh giá được xây dựng nhằm loại bỏ lối diễn đạt máy móc, cắt giảm các biểu tượng cảm xúc dư thừa hoặc thái độ nịnh nọt thái quá của trợ lý ảo. Đội ngũ kiểm duyệt cũng phải bảo đảm rằng ChatGPT không tự xưng "tôi" theo xu hướng nhân hóa như một con người thực thụ. Tiết lộ từ một nhân sự tham gia dự án cho biết công việc mang tính lặp đi lặp lại rất cao, song bộ quy tắc hướng dẫn lại thường xuyên bị thay đổi đột ngột, thậm chí tồn tại nhiều điểm mâu thuẫn lẫn nhau.
Nguy cơ rò rỉ dữ liệu nhạy cảm và lỗ hổng từ khâu ẩn danh
Nhằm bảo đảm quyền riêng tư, các cuộc trò chuyện trước khi gửi đến tay đội ngũ kiểm duyệt đều phải trải qua bước "làm sạch và ẩn danh" để loại bỏ danh tính người dùng. Dẫu vậy, đại diện OpenAI đã thừa nhận với 404 Media rằng các thuật toán sàng lọc vẫn có thể vô tình để lọt một số thông tin cá nhân nhạy cảm, đặc biệt là trong các cuộc trò chuyện ngắn gọn.
Điều đáng báo động là trong rất nhiều phiên trò chuyện, người dùng đã chủ động yêu cầu ChatGPT giữ bí mật tuyệt đối các nội dung trao đổi. Không ít người xem chatbot như một bạn tâm giao hay chuyên gia tâm lý đáng tin cậy để giãi bày những tâm sự thầm kín nhất của bản thân. Thế nhưng, bản hội thoại chuyển tới tay người kiểm duyệt được cho là đính kèm cả "bản tóm tắt bộ nhớ người dùng" — một tài liệu tổng hợp toàn bộ các thắc mắc, mối quan tâm, sở thích cá nhân, bối cảnh đời sống, thậm chí là cả vị trí địa lý của đối tượng tương tác.
Bẫy cài đặt mặc định và sự phụ thuộc vào sức lao động thủ công
Thực tế hiện nay, tính năng cho phép sử dụng dữ liệu để cải thiện sản phẩm luôn được các nhà phát triển bật sẵn theo mặc định trên hầu hết dịch vụ chatbot phổ biến, áp dụng cho cả các tài khoản trả phí. Người dùng hoàn toàn có thể chủ động tắt tính năng này trong phần cài đặt, tuy nhiên thao tác trên sẽ không có hiệu lực hồi truy đối với các thông tin đã bị hệ thống thu thập và nạp vào kho dữ liệu từ trước.
Khi bị chất vấn về tính minh bạch trong việc thông báo cho người dùng, OpenAI từng dẫn lại trang câu hỏi thường gặp (FAQ) được ban hành từ nhiều năm trước có đề cập việc con người tham gia đánh giá dữ liệu. Tuy nhiên, 404 Media cho biết ngay sau khi báo cáo điều tra được công bố, OpenAI đã âm thầm cập nhật lại trang thông tin này: họ bổ sung hướng dẫn cách từ chối thu thập dữ liệu nhưng lại lặng lẽ xóa bỏ chi tiết nhắc đến sự tham gia của các nhân sự kiểm duyệt là con người.
Ghi nhận từ trang tin công nghệ Tom's Hardware, thực trạng kiểm duyệt dữ liệu thủ công không chỉ diễn ra riêng tại OpenAI. Ngay trong điều khoản bảo mật của Gemini cũng công khai nêu rõ việc con người có thể xem xét một số đoạn trò chuyện được lưu trữ, và Anthropic cũng đang áp dụng chính sách tương tự. Việc các tập đoàn công nghệ vẫn phải dựa vào con người để thu thập và đánh giá thủ công là minh chứng rõ nét cho thấy các mô hình AI hiện đại vẫn phụ thuộc rất lớn vào sức lao động thủ công, thay vì có khả năng tự hoàn thiện thuần túy thông qua các thuật toán tự động.
PV (SHTT)

Bài đọc nhiều